Anthropicは2026年9月22日、Claude Opus 5.5(claude-opus-5-5)を公開した。公式ページは「新しいClaude 5.5ファミリーの最初のモデル」と位置づけ、ほとんどの作業でClaude Fable 5.1と同等の性能を出しながら、Opus 5より40%安く動かせると書いている。ただしこの40%は単価の下げ幅ではない。単価は20%減で、残りは別の要因の積み上げだ。さらに、安くなった一方でOpus 5向けのコードがそのままでは400になる破壊的変更が4点ある。本記事では公式ページと公式ドキュメントの記載だけを使い、値下げの内訳と移行時に必ず踏む変更点を整理する。
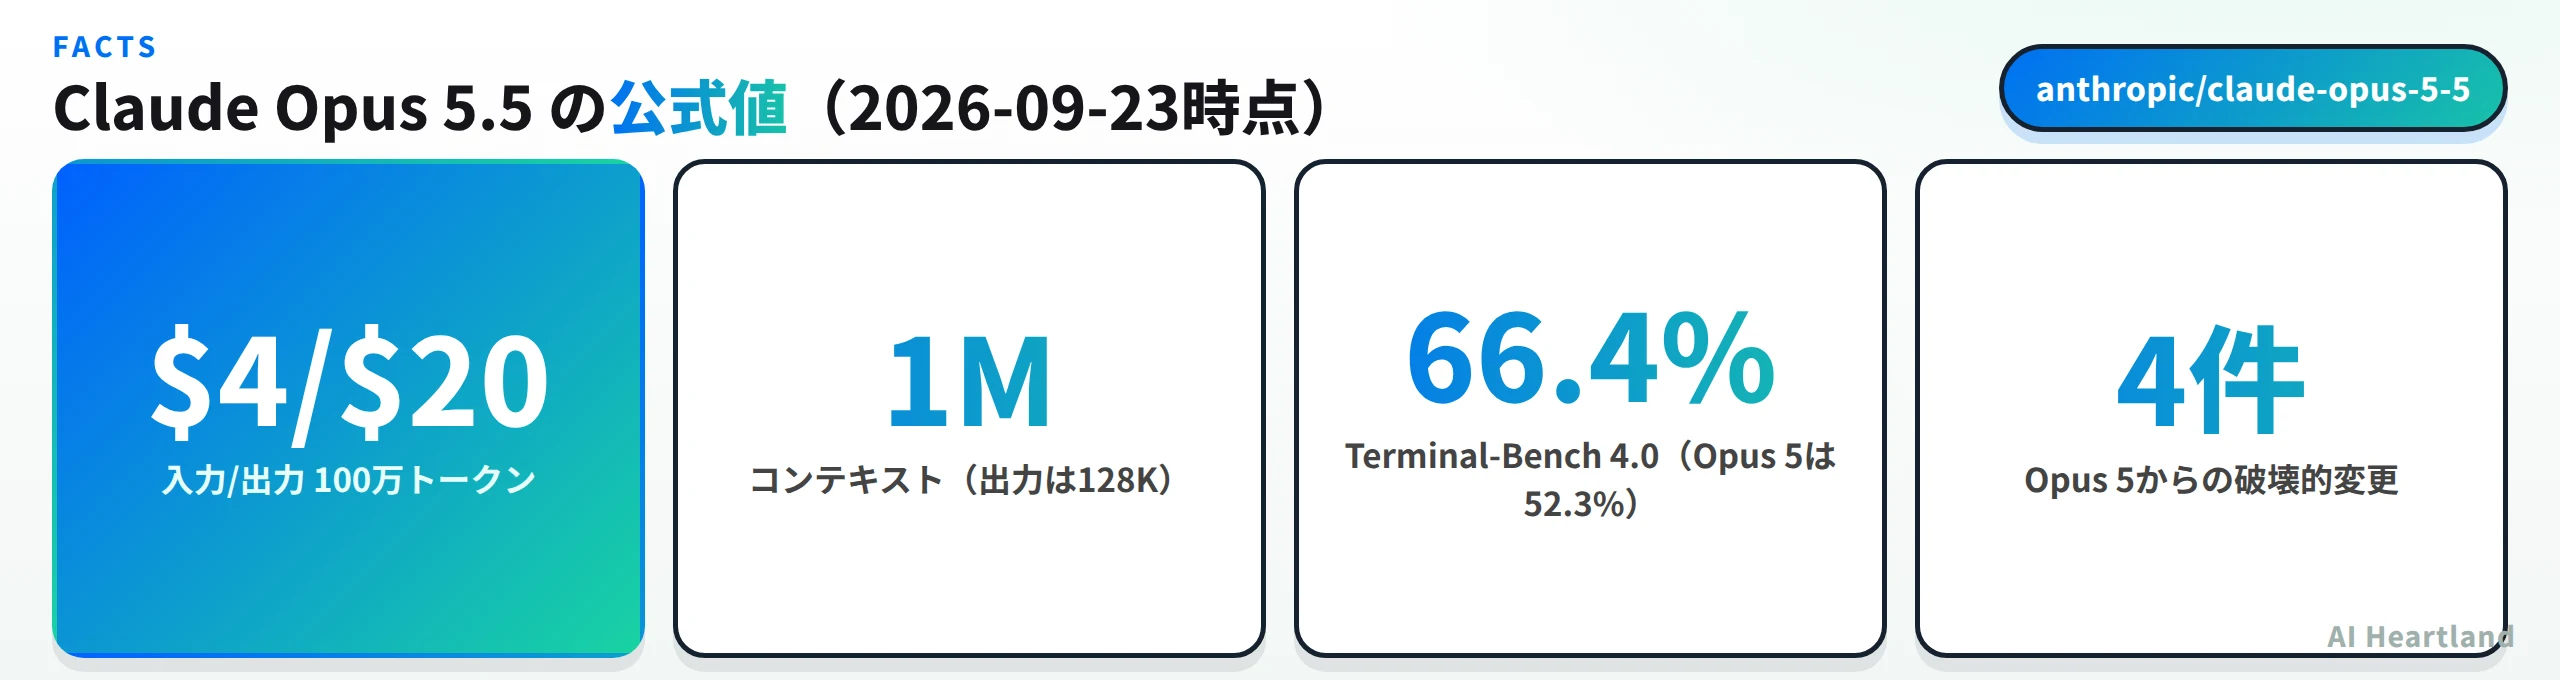
- ・モデルID:`claude-opus-5-5`。コンテキスト1M・最大出力128K・知識のカットオフは2026年6月
- ・料金:入力$4/出力$20(Opus 5比20%減)。キャッシュ読みは$0.20(60%減)
- ・性能:Terminal-Bench 4.0で66.4%(Opus 5は52.3%、Fable 5.1は55.8%)
- ・注意:thinking無効化・強制ツール指定・旧computer useツールがいずれも400。effortの既定もhighからmediumへ
前世代の位置づけと読み方はClaude Opus 5とは|読み方・Opus 4.8からの変更点・料金・移行点を解説にまとめた。単価を自分の使い方に当てはめる計算はClaude API 料金完全ガイド2026|Sonnet 5/Opus 4.8/Fable 5を計算機で試算が使える。
Claude Opus 5.5とは——Opus 5の後継が安くなった
まず事実関係を押さえる。Opus 5.5はOpus系列の後継で、Opus 5を置き換えるのではなく並んで提供される。公式ページが挙げる用途は、エージェント的なコーディング、コンピュータ操作、ナレッジワーク、そして長時間の自律タスクだ。
| 項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| モデルID | claude-opus-5-5 |
claude-opus-5 |
| 入力 / 出力(100万トークン) | $4 / $20 | $5 / $25 |
| キャッシュ読み / 書き込み | $0.20 / $5 | $0.50 / $5 |
| 高速モード(Claude APIのみ) | $8 / $40 | $10 / $50 |
| コンテキスト / 最大出力 | 1M / 128K | 1M / 128K |
| effort の既定 | medium |
high |
| thinking の無効化 | できない(400) | effort high以下なら可 |
コンテキスト長も最大出力もトークナイザーもOpus 5と同じだ。トークン数が変わらないので、同じプロンプトなら入力トークンの見積もりをやり直す必要はない。知識のカットオフは2026年6月と公表されている。公式ページは、Opus 5向けに書いたプロンプトはそのままでも良好に動くとしている。
提供先はClaude API、Claude Code、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry。BedrockではIDに接頭辞が付き anthropic.claude-opus-5-5 になる。高速モードはClaude APIのみで、出力速度を上げる代わりに単価が2倍になる。公式ドキュメントはこれを研究プレビューと位置づけており、パートナー運営のクラウドやClaude Platform on AWSでは使えない。Opus 4.7では speed: "fast" がエラーになり、Opus 4.6では指定しても通常速度で通常料金になる、という世代ごとの違いも明記されている。
公式ページは、サイバーセキュリティ関連の作業の大半をOpus 4.8へ振り替えると書いている。生物学の研究用途はLife Sciences Verification Programの承認が必要で、セキュリティ専門職向けのアクセスはCyber Verification Programの拡大版を通す。安全性分類も広がり、Opus 5で対象だった `cyber` に加えて `bio` と `reasoning_extraction` が入った。該当分野の業務で使う予定があるなら、単価より先にここを確認したい。
「40%安い」の内訳——単価と実行コストを分けて読む
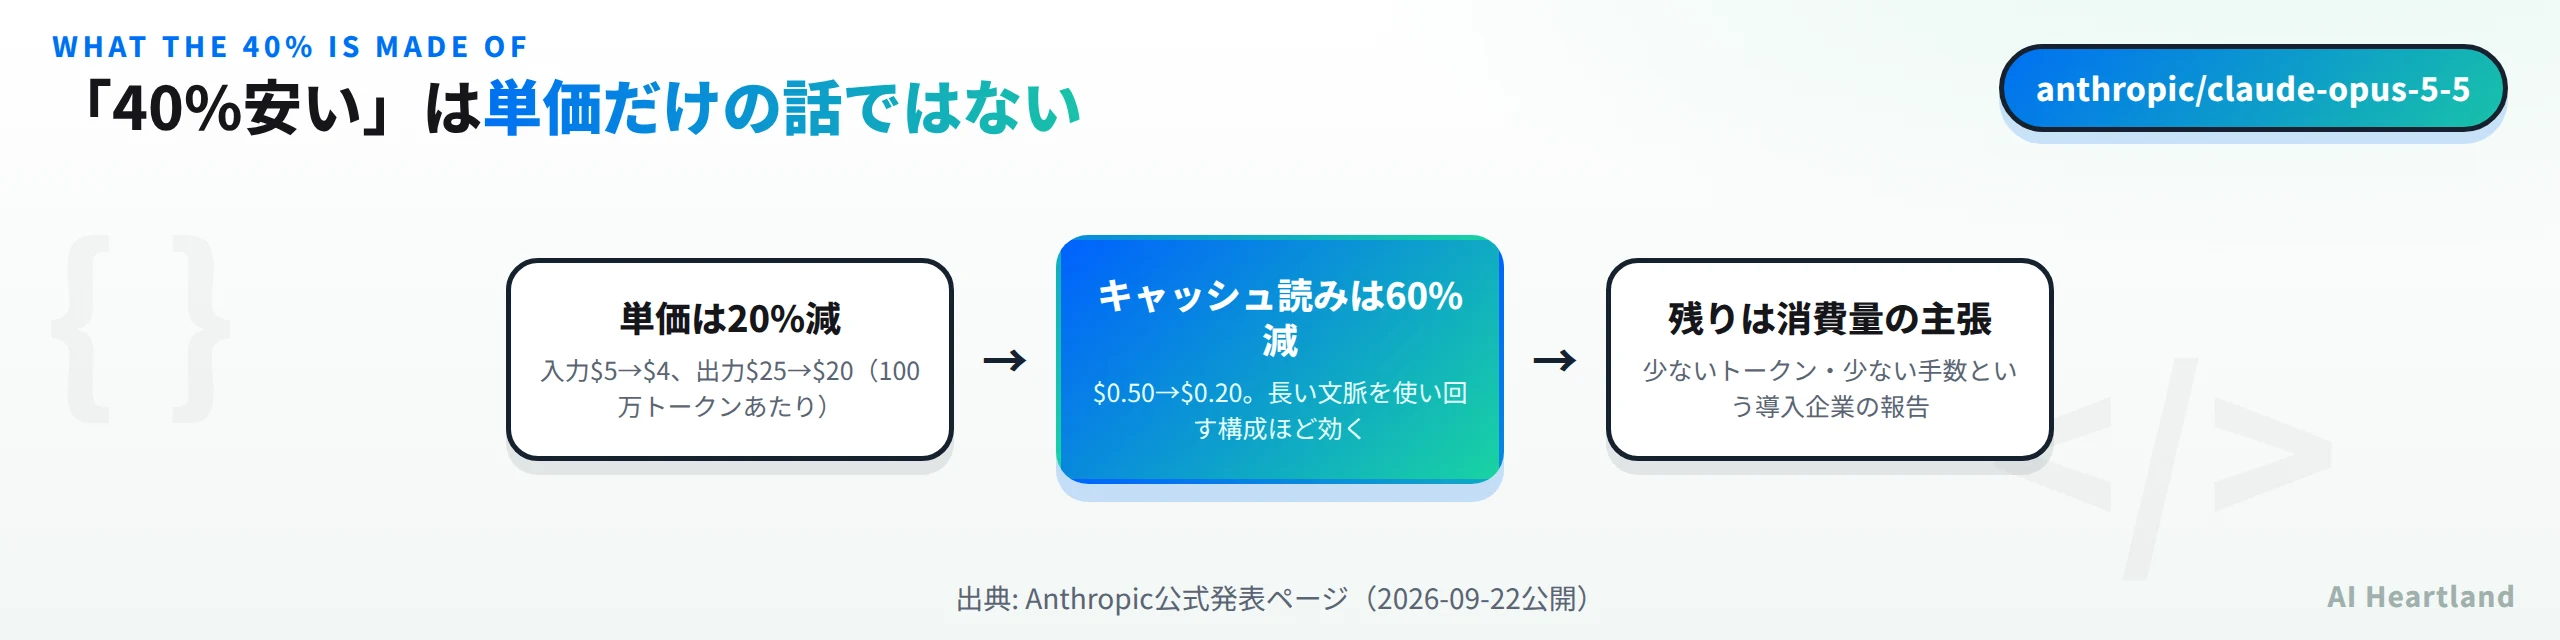
公式ページの見出しは「Opus 5より40%安く動かせる」だが、価格表の下げ幅は20%だ。この差は誤りではなく、別々のものを指している。
内訳は3つに分けられる。
・単価の20%減:入力$5→$4、出力$25→$20。これは誰が使っても効く
・キャッシュ読みの60%減:$0.50→$0.20。長い文脈を繰り返し使う構成ほど効き、使っていなければ効かない
・消費量の削減:導入企業の報告として、より少ないトークンと手数で終わったという事例が並ぶ
3つ目は価格表から計算できない。公式ページが引用しているのは、GitHubの「計測した中でもっとも少ないトークンと手数だった」、Lovableの「3分の1から半分の手数で終える」、Optiverの「Opus 5と同等の品質を、半分のターン・時間・出力トークンで達成した」、Boxの「Opus 5の3分の1のトークンで、回答は40%簡潔だった」といった声だ。いずれも各社の環境での結果であり、測定条件は公開されていない。
キャッシュ読みの下げ幅が大きいのには理由がある。公式の料金ドキュメントによれば、キャッシュヒットの単価は通常「基本入力価格の0.1倍」で計算されるが、Opus 5.5はこの倍率自体が0.05倍に変わっている。基本入力が$5から$4に下がったぶん(20%減)と、倍率が半分になったぶんが掛け合わさって60%減になる。同じ扱いを受けているのはClaude Fable 5.1とMythos 5.1(0.025倍)だけで、他のモデルは0.1倍のままだ。
キャッシュ書き込みと一括処理の価格も下がっている。5分キャッシュの書き込みは$6.25から$5へ、1時間キャッシュは$10から$8へ。バッチAPIは入力$2.50→$2、出力$12.50→$10だ。いずれも基本価格の20%減がそのまま反映された形で、倍率が変わったのはキャッシュ読みだけになる。
| 項目 | Opus 5.5 | Opus 5 |
|---|---|---|
| 5分キャッシュ書き込み | $5 | $6.25 |
| 1時間キャッシュ書き込み | $8 | $10 |
| キャッシュ読み | $0.20(0.05倍) | $0.50(0.1倍) |
| バッチ 入力 / 出力 | $2 / $10 | $2.50 / $12.50 |
したがって読み方はこうなる。単価の20%は確実に効く。残りは自分の構成に依存する。キャッシュを使っていないワークロードなら、期待値は40%ではなく20%前後から考えるのが安全だ。逆に長いシステムプロンプトを毎回使い回す構成なら、キャッシュ読みの60%減が効いて40%に近づく余地がある。出力生成の速度についても「Opus 5より30%以上速い」と書かれているが、これは料金ではなく所要時間の話で、時間課金でない限りコストには直結しない。
公称ベンチマークの読み方——何と何を比べた数字か
Opus 5の発表では相対値が中心だったが、今回は絶対スコアの比較表が公開されている。主要なものを抜き出す。
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 |
| AutomationBench | 40.0% | 31.4% | 26.9% |
| Humanity’s Last Exam(ツールあり) | 67.7% | 65.6% | 63.6% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% |
| OSWorld 2.0(部分点) | 81.8% | 80.7% | 74.0% |
表を見るときに押さえたい点が3つある。
第一に、比較対象にFable 5.1が入っている。公式ページの「ほとんどの作業でFable 5.1と同等」という主張は、この列との対比から来ている。Fable 5.1はOpus系列より上位に位置づけられ単価も高いので、「上位モデル級の性能をOpus価格で」という構図になる。ただし全項目で上回っているわけではなく、Humanity’s Last ExamやOSWorldのように差が1〜2ポイントの項目もある。
第二に、他社モデルとの比較では負けている項目がある。公式ページの表にはGPT-6 AstraとGPT-5.6 Solも並んでおり、AutomationBenchではGPT-6 Astraが41.4%でOpus 5.5の40.0%を上回り、Terminal-Bench-Science 0.1でも64.6%対58.7%で上回っている。自社に不利な数字を残した表になっている点は、読む側としては評価できる。
第三に、条件つきの数字がある。Humanity’s Last ExamとChartographyは「ツールあり」、OSWorld 2.0は「部分点」と注記されている。条件が違う数字を並べて比較しないほうがいい。
個別の事例としては「あるテスターが68万行のコード移行を1日未満で完了した。エンジニアチームなら数週間かかる作業だった」という記載や、Deloitteの「既知のバグの72%を検出した(Opus 5は56%)」という報告も挙がっている。いずれも単一の事例なので、再現性のある数字としては扱えない。
安全性については、自動化された行動監査で「これまでテストした中でもっとも強い結果」、「取り返しのつかない行動や境界を越える行動を取る可能性が最近のモデルより大幅に低い」、「プロンプトインジェクションへの耐性がOpus 5より高い」、そして封じ込め境界を回避しようとする頻度がOpus 5より85%少ないと書かれている。エージェントに長時間の自律作業をさせる用途では、ベンチマークのスコアよりこちらのほうが効く場合がある。
Opus 5からの破壊的変更4点——コードを直す場所
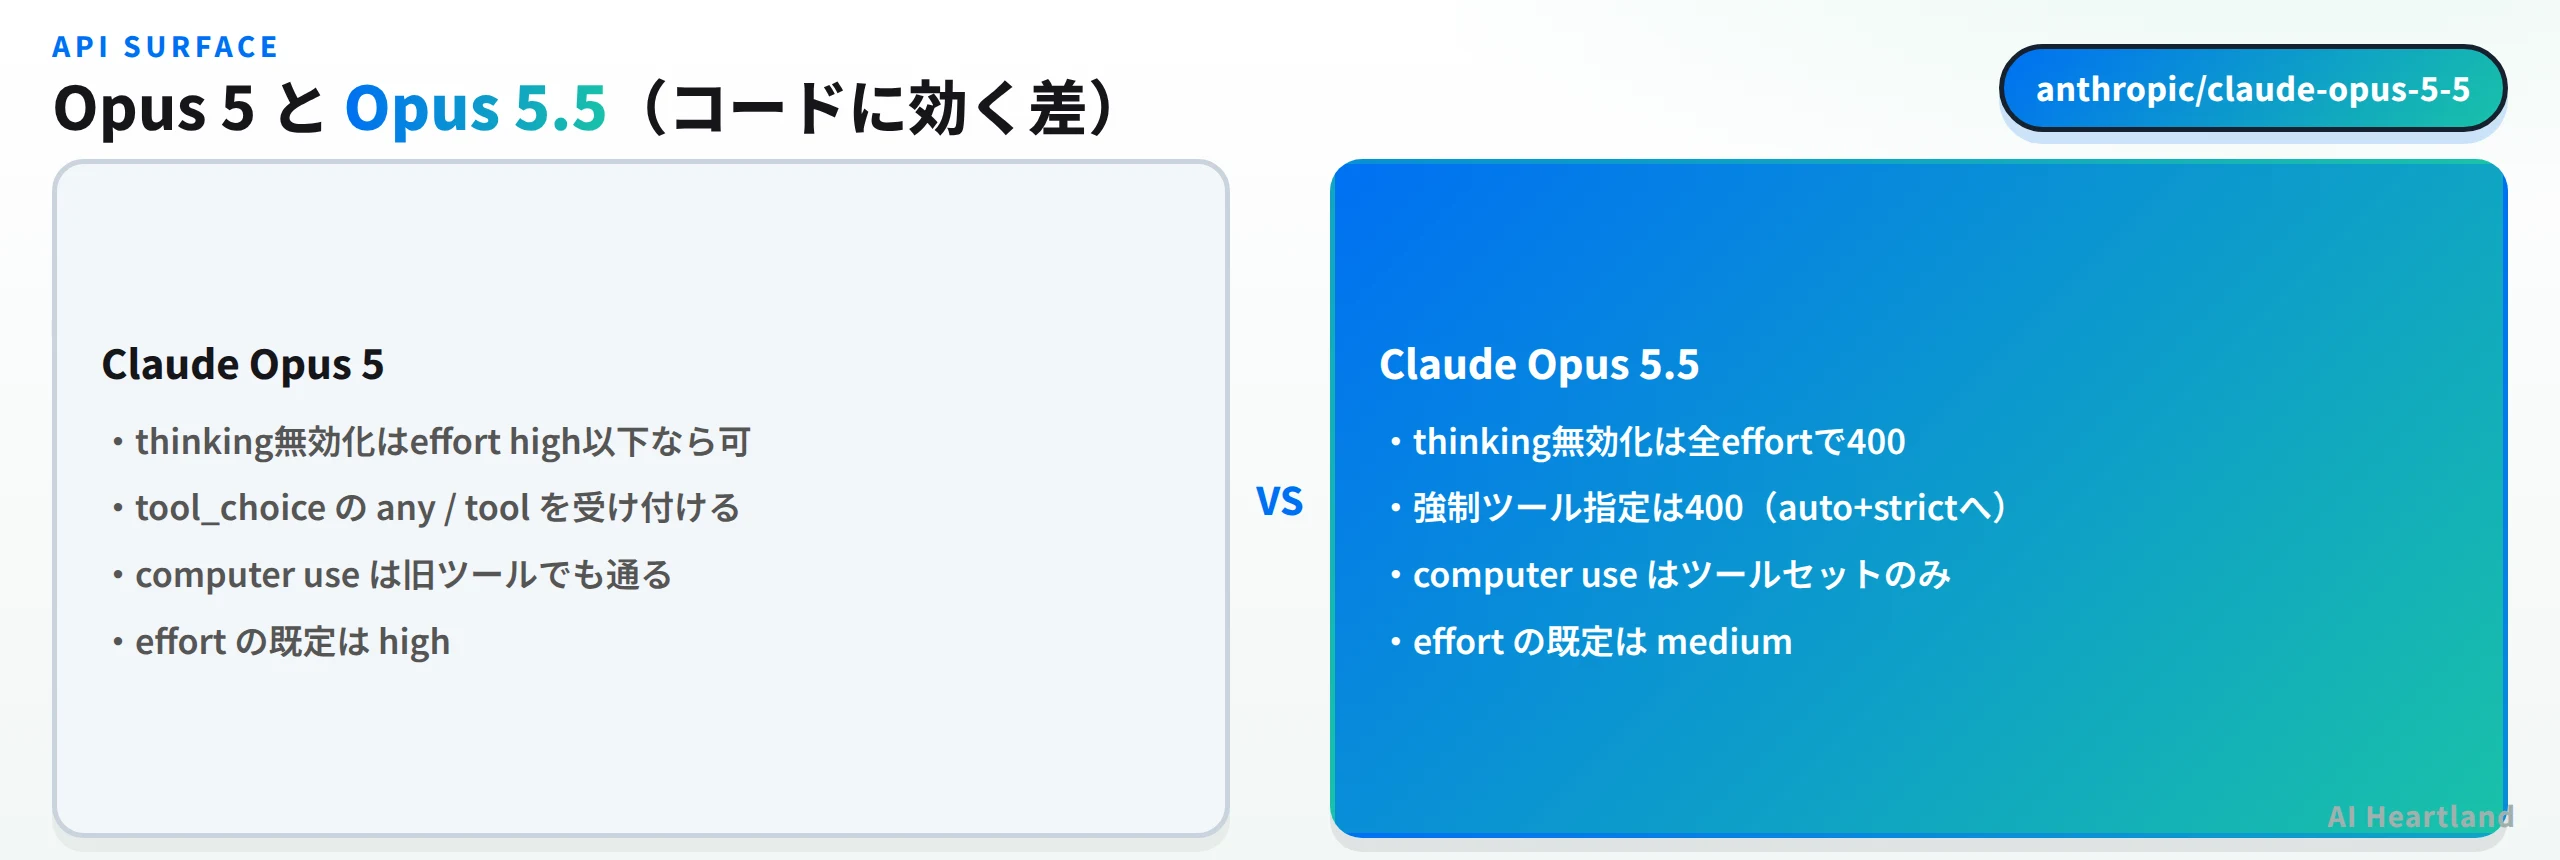
ここが実務でいちばん重要だ。モデルIDを差し替えるだけでは動かないコードがある。公式ドキュメントが挙げる破壊的変更は4点で、いずれも400エラーになる。
effort low で代替"] B -->|いいえ| D["tool_choice に any / tool?"] C --> D D -->|はい| E["auto + strict へ
呼ばれたか検査を追加"] D -->|いいえ| F["computer use を使う?"] E --> F F -->|はい| G["computer_toolset_20260801 へ"] F -->|いいえ| H["effort を明示指定して差し替え"] G --> H
1. thinkingを無効化できない。Opus 5では thinking: {"type": "disabled"} がeffort high以下で受け付けられたが、Opus 5.5では全effortレベルで400になる。budget_tokens を渡す古い形も同様だ。代わりに thinking の指定自体を外し({"type": "adaptive"} と等価)、思考の量は output_config.effort で制御する。最初のトークンまでの時間を短くしたいなら low から始めて測る、という手順がドキュメントに示されている。思考のテキストは既定では返らないが、トークンとしては max_tokens を消費する点にも注意がいる。
この記事のポイント
・「40%安い」のうち価格表から確実に効くのは20%。残りはキャッシュの使い方と消費量の主張に依存する
・Opus 5向けのコードは4点で400になりうる。thinking無効化・強制ツール指定・旧computer useツール・そしてeffortの既定変更
・ベンチマーク表はFable 5.1と他社モデルを含み、負けている項目も残されている
2. 強制的なツール指定が拒否される。tool_choice: {"type": "any"} と {"type": "tool", "name": "..."} が400になる。Messages APIだけでなくバッチAPIとトークンカウントでも同じだ。移行の型は用途で分かれる。特定のツールを使わせたいだけなら {"type": "auto"} にしてプロンプトでツール名を明示し、引数の形を守らせるためにツール定義へ strict: true を付ける。autoは呼び出しを保証しないので、呼ばれたかどうかを確認して呼ばれていなければ再試行する処理が要る。JSONを取り出すために強制していただけなら、構造化出力(output_config.format)へ置き換えるほうが素直だ。この変更は料金表からも裏が取れる。ツールを使うときに自動付与されるシステムプロンプトのトークン数は、Opus 5では auto/none が286トークン、any/tool が406トークンと2段で書かれているが、Opus 5.5の行は286トークンの1段しかない。強制指定が受け付けられないので、その分の記載自体が消えている。
3. thinkingブロックがモデルと会話に紐づく。いわゆる「preserved thinking」で、Opus 5.5が生成したthinkingブロックを読めるのはClaude APIではFable 5.1とMythos 5.1だけになる。ルーターでの切り替えや、拒否時のフォールバックでOpus 5へ落とすと、切り替え後のターンはOpus 5.5の推論を持たないまま進む。読めないブロックはAPI側が落とすので請求もされないが、挙動は変わる。もう一方の「会話への紐づけ」は、systemプロンプト・toolsの配列・それ以前のメッセージがブロック生成時とバイト単位で同じであることを求めるもので、2026年8月31日以降に作成されたアカウントでは既定で強制される。自分で messages を組み立てているコードは、途中でリマインダーを差し込んで消す、systemを差し替える、途中でツールを増減する、といった編集をやめて追記のみの構成にする必要がある。Claude Codeやclaude.aiを使っている分には影響しない。
4. computer useは新しいツールセットのみ。Opus 5はベータヘッダ付きで旧 computer_20251124 も受け付けたが、Opus 5.5は computer_toolset_20260801 だけを受け付ける。単なるツール名の置換では済まず、リクエスト側では name と画面サイズの指定が不要になり、エージェントループ側では操作の種類が input.action ではなくブロックの name に入る形に変わる。1ターンに複数の操作ブロックが来ることもあり、結果を返すときは全ブロックに "toolset_name": "computer" を付ける。両方を受け付けるOpus 5の側で先に直して試すのが安全だ。
このほか、エラーにはならないが挙動が変わる点がひとつある。Opus 5ではツール呼び出しの合間に書かれる短い説明が text ブロックで返っていたが、Opus 5.5では進捗を示す thinking ブロックとして返る。既定の表示設定では中身が空なので、text ブロックだけを描画しているUIは長いターンの間ずっと無言になる。
effortの既定がmediumに下がる——移行で最初に見る設定
破壊的変更ではないが、品質に直接効くので独立して扱う。Opus 5のeffort既定は high だったが、Opus 5.5は medium が既定になった。
つまりモデルIDだけ差し替えると、思考の深さが1段階下がった状態で動く。コストを下げたいなら意図どおりだが、品質を保ちたいなら output_config: {"effort": "high"} のように明示する必要がある。逆に、応答の速さを優先するルートなら low を選べる。thinkingを切れなくなった分、effortが唯一の制御になった。
実務的な当てはめ方は3つに整理できる。第一に、コーディングや長時間のエージェント作業は効きやすい領域なので high 以上を検討する。第二に、チャットや分類、大量処理のように判断の深さを要求しないルートは low や medium で足りることが多い。第三に、既定値の変更に気づかないまま「新しいモデルにしたら品質が落ちた」と判断しないよう、移行時は必ず明示指定して比較する。
なお公式ページは、Opus 5向けに書かれたプロンプトはそのままでも良好に動くとしている。プロンプトの全面的な書き直しは前提になっていない。thinkingを無効にしていたルートだけは例外で、思考の代わりに推論を本文へ書かせていた指示は外し、表示設定で要約を受け取る形に変える、という手順が示されている。
まとめ——差し替える前に見る順番
Claude Opus 5.5は、単価を下げつつAPIの表面を締めたモデルだ。値下げの見出しだけを見て差し替えると、thinking無効化や強制ツール指定を使っているコードが400で止まる。
先に直す:thinking無効化・`tool_choice` の any / tool・旧computer useツールを使っている箇所。`messages` を自前で組み立てていて途中編集があるコード
様子を見る:サイバーセキュリティ関連や生物学研究の用途(振り替えや承認プログラムの対象)。40%の値下げをキャッシュ未使用の構成で見込んでいる場合
本記事の数値はすべてAnthropicの公式ページと公式ドキュメントの記載で、当サイトが実測したものではない。ベンチマークの再現も行っていない。移行するなら、まず自分のプロンプトで effort を明示したうえでOpus 5と同じ入力を流し、出力トークン数と手数の差を自分で測るのが、40%という数字を自分の環境に翻訳する唯一の方法になる。
参照ソース
・Claude Opus 5.5(Anthropic公式ページ) — 料金・ベンチマーク表・提供プラットフォーム・安全性の記載(2026-09-23確認)
・Pricing(Anthropic公式ドキュメント) — 単価表・キャッシュ倍率・バッチ価格・高速モード価格・ツール利用時のシステムプロンプトトークン数(2026-09-23確認)
・Claude Opus 5とは|読み方・Opus 4.8からの変更点・料金・移行点を解説 — 前世代の位置づけと、公称ベンチの読み方
・Claude Sonnet 5のAPI実装ガイド|adaptive thinking・effort・新トークナイザー — adaptive thinkingとeffortの基本的な使い分け