LayaとJevは、どちらも「文章を書かないモデル」だ。yes/no・選択・スコアといった型つきの質問に、文章ではなく確率だけを返す。用途が重なるので比較されやすいが、2026年9月時点の一次情報を突き合わせると、比べるべきは速度ではなく前提条件だと分かる。重みが手に入るか、どこで動くか、自分で検証できるか、どんな上限があるか。本記事はその4点を、各プロジェクトのREADMEと当サイトの実測記事をもとに整理する。公称レイテンシを直接比べてはいけない理由も具体的に示す。
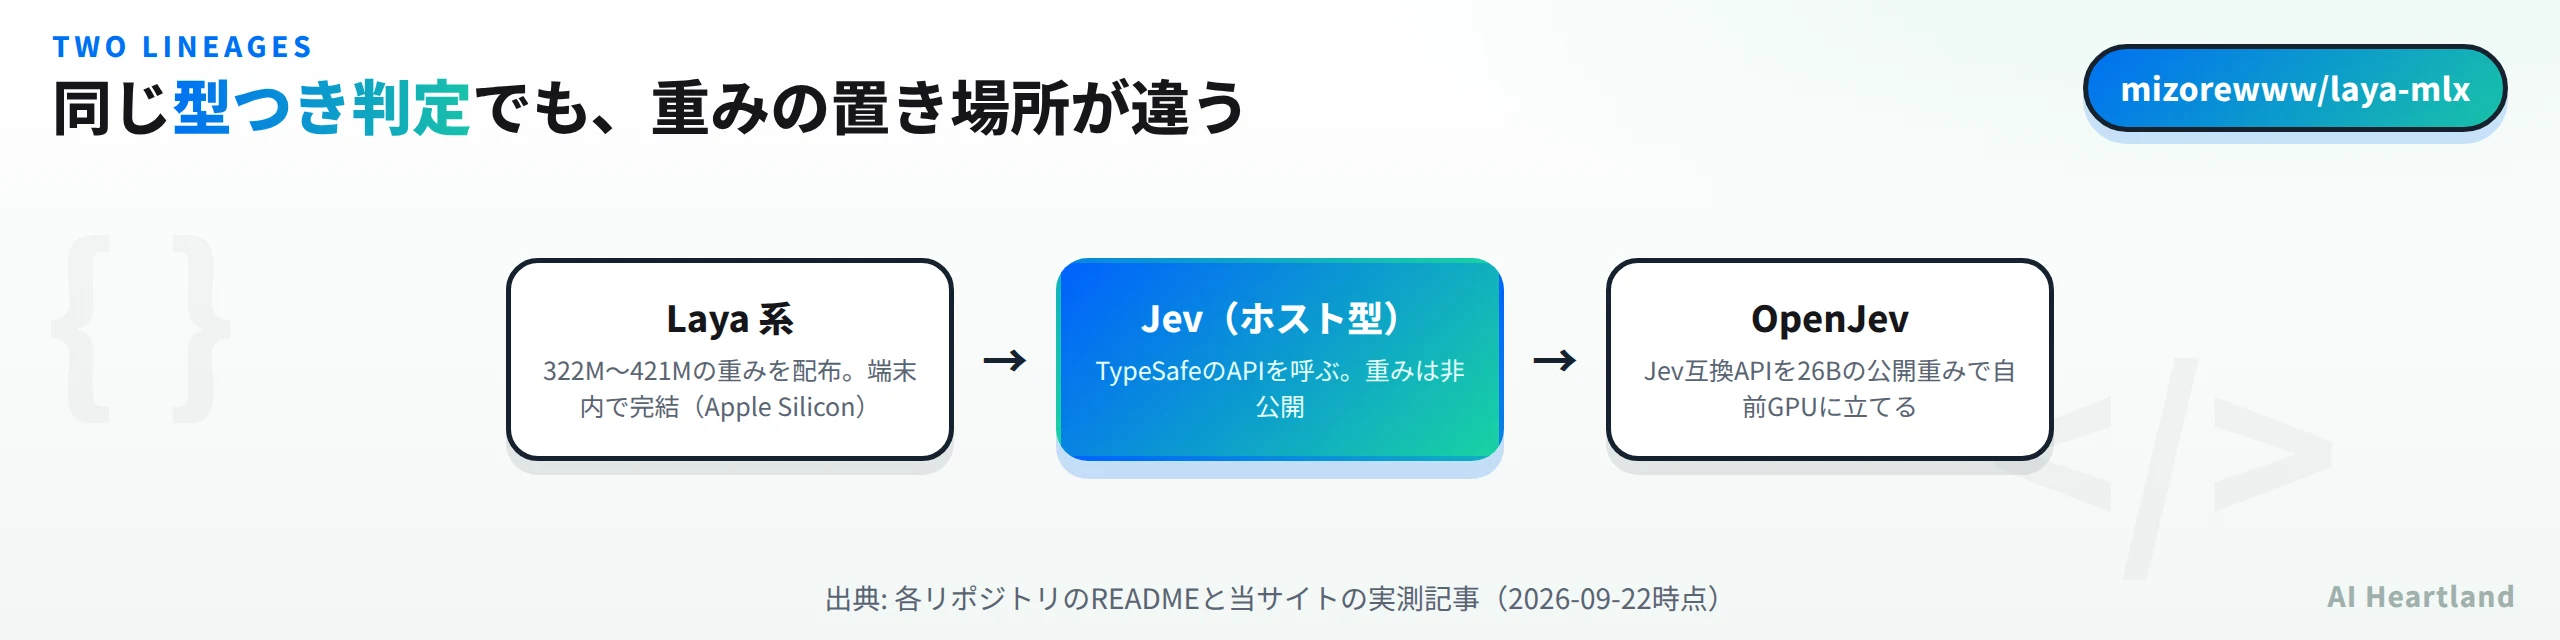
- ・入手性:Layaは重みが公開。Jevはホスト型で非公開。OpenJevは別の公開モデルでJev互換APIを提供
- ・規模:Layaは322M〜421M、OpenJevが載せるモデルは26B。2桁違う
- ・検証:Laya側は重みのチェックサムと移植一致378件を公開。ホスト型は公称値のみ
- ・注意:各プロジェクトの公称レイテンシは測定機もハーネスも違うので、引き算してはいけない
そもそも判定だけを返すモデルという発想についてはLLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版の系譜が前提になる。
用語の整理——LayaとJevは同じ層の別物
先に呼び名を揃えておく。混同しやすい名前が3つある。
・Jev:TypeSafeが提供するSystem Oneモデル。ホスト型のAPIとして提供され、公式SDKがある。重みは公開されていない
・Laya:Convai Innovationsと上流の貢献者による判定モデル。学習済み重みが公開されており、ModernBERT系とmmBERT系のエンコーダを使う
・OpenJev:Jevと同じwire APIを話す独立のオープンソース実装。中身はJevの重みではなく、Apache-2.0で公開されている別の拡散モデルを載せている
つまり「Jevの代わり」には2通りの意味がある。APIの互換を取る道(OpenJev)と、判定モデル自体を別系統に替える道(Laya)だ。前者はコードを変えずに済むが必要なGPUが大きい。後者はモデルが小さく端末に載るが、APIも挙動も別物になる。
Jevそのものの設計と、公称されている性能の数字がどう作られているかはJevとは|文章を返さないSystem Oneモデルの正体を公式SDKのコードで実測し、Claude Codeで試すで扱った。本記事はその上に「では別系統と比べるとどうか」を重ねる。
4つの軸で比べる——入手性・実行場所・検証可能性・制約
一次情報から確認できる範囲を表にする。数値はいずれも各プロジェクトのREADMEの記載で、当サイトが同一条件で測り直したものではない。
| 観点 | Laya(MLX/Core ML移植) | Jev(ホスト型) | OpenJev(Jev互換サーバ) |
|---|---|---|---|
| 重みの入手 | 公開。Hugging Faceで配布 | 非公開 | 別モデル(Apache-2.0)を利用 |
| パラメータ規模 | 322M〜421M | 非公表 | 26B(A4B構成) |
| 実行場所 | 手元のApple Silicon | 提供側のクラウド | 自前のGPUまたはApple silicon |
| 必要ハードウェア | Apple Silicon・macOS 14以上 | 不要(APIを呼ぶだけ) | NVIDIA 24GB以上/Apple silicon約16GB |
| 質問の型 | choice・score・noul | choice・score・noul | choice・score・noul |
| 選択肢の上限 | トークン予算を共有(絞り込み機能あり) | 255 | 128 |
| 文脈上限 | 512/1,024トークン | 公表値を確認できず | モデル設定に依存 |
| ライセンス | 移植はApache-2.0 | 商用サービス | Apache-2.0 |
| 状態の送信先 | 端末内 | 提供側API | 自分が立てたサーバ |
質問の型が3種類で一致しているのは偶然ではない。どちらの系統も「選択・順序つきスコア・真偽」という同じ問題設定を扱っており、だからこそ移行の検討対象になる。呼び名まで揃っているのも特徴で、真偽を問う型はどちらの系統でも noul と呼ばれる。用語が共通なぶん、設計書のレベルでは置き換えを検討しやすい。
一方で、表の「選択肢の上限」の行は読み方に注意がいる。Jevの255とOpenJevの128は明示された件数の上限だが、Laya系には件数の上限という形の制約が無い代わりに、選択肢全体が1つのトークン予算を共有する。ラベルが数百あると1件あたり数トークンしか割り当たらず、説明文が切り詰められて判定の質が落ちる。上限に当たってエラーになるか、静かに精度が落ちるかという違いなので、後者のほうが運用では気づきにくい。だからLaya-MLXには、状態と各ラベルを埋め込んで上位k件に絞ってから判定する機能が別途用意されている。
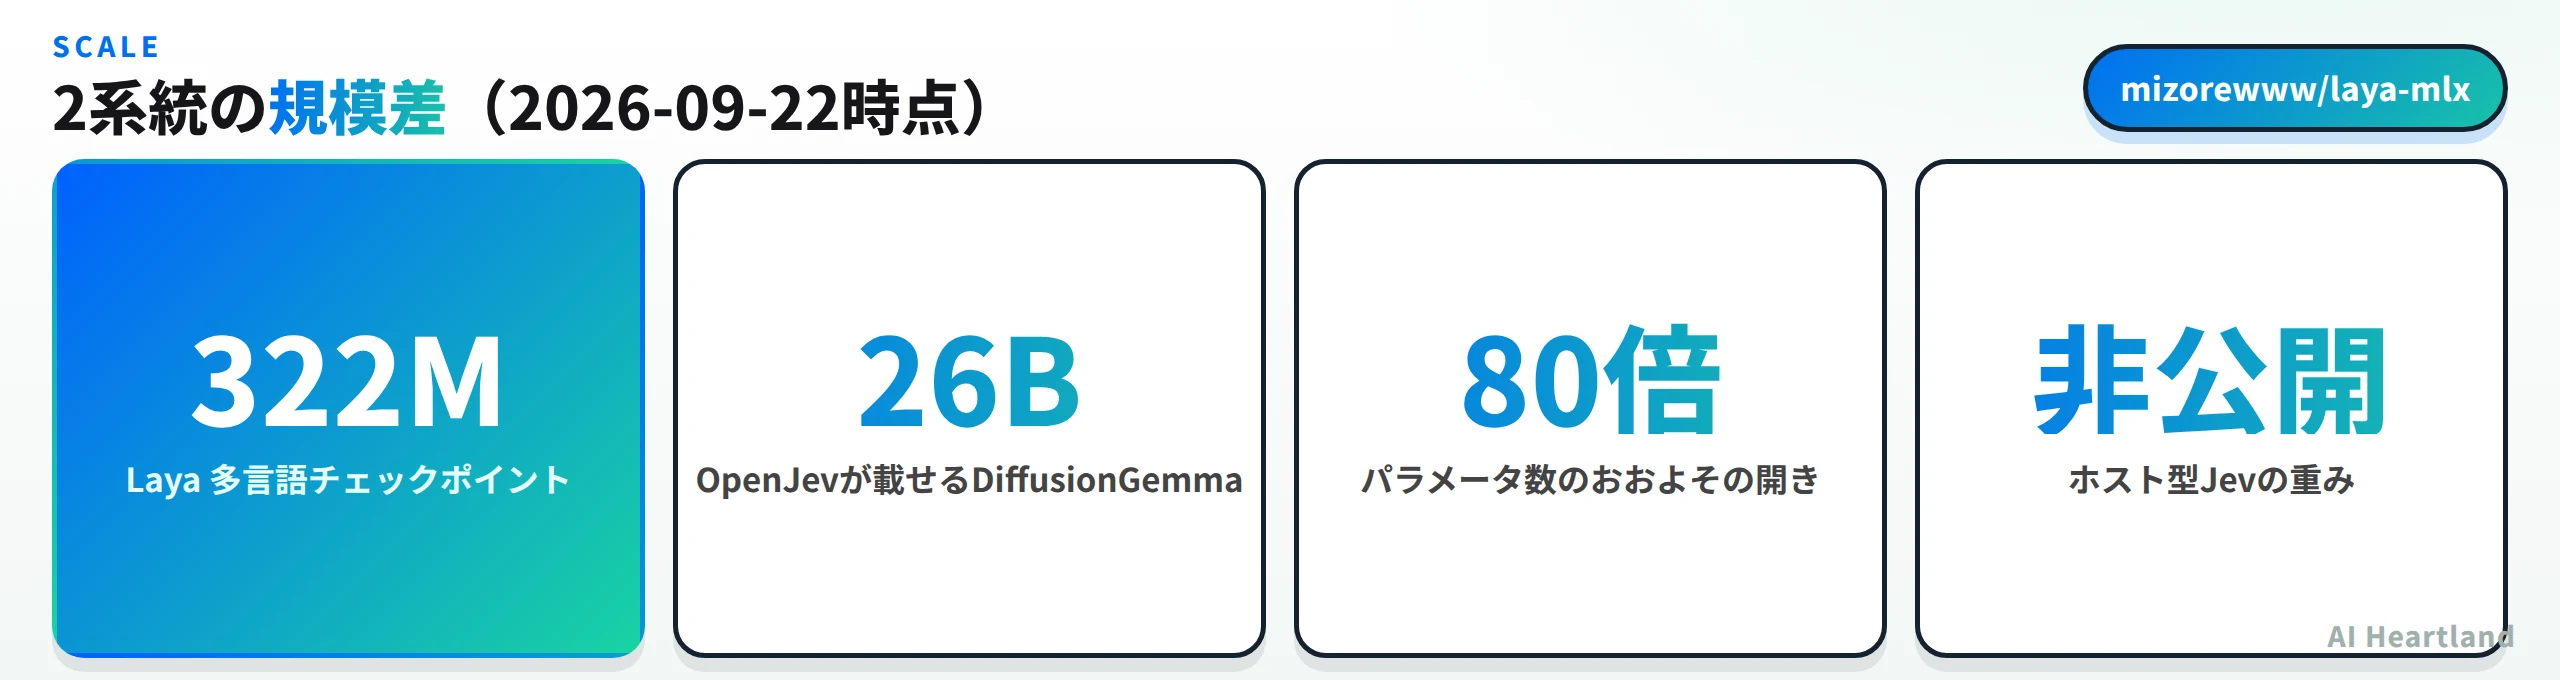
規模の差は運用の差にそのまま出る。322Mのモデルはノートパソコンのメモリに収まり、READMEの実測でもMLXのピーク確保は687.6MiBだった。26Bのモデルは24GB以上のGPUメモリを要求し、重みのダウンロードだけで約18GBになる。同じ「型つき判定」という言葉で括られていても、置き場所の要求がまったく違う。
公称レイテンシを比べてはいけない理由
この2系統は、どちらも歯切れのよい数字を掲げている。Laya-MLXは短い質問1件でP50 7.39ミリ秒、Core ML版は4.98ミリ秒、OpenJevは並列1でp50 94ミリ秒。並べたくなるが、並べても意味がない。
M3 Max と RTX PRO 6000"] A --> C["質問数が違う
1問 と 3問"] A --> D["含む工程が違う
準備・整形を含むか"] A --> E["モデルが違う
322M と 26B"] B --> F["直接の比較は成立しない"] C --> F D --> F E --> F F --> G["自分の負荷で測り直す"]
Laya側の数字はM3 Max(40 GPUコア・128GiB)で、短い質問1件について、プロンプト準備・トークン化・テンソル生成・同期推論・較正・結果整形までを含み、モデル読み込みを除いて測られている。OpenJev側の数字はRTX PRO 6000をGPU使用率38%で回し、質問3個のリクエストをキャッシュが効かない状態で投げた測定だ。機械も、質問数も、含まれる工程も、モデルの大きさも違う。
同じ系統の中ですら、ハーネスが違えば数字は動く。Core ML版のREADMEは比較対象として「コンパイル済みMLX FP16でP50 6.94ミリ秒」と書いているが、MLX版のREADMEは同じ多言語チェックポイントについて「P50 7.39ミリ秒」と書いている。どちらも嘘ではなく、質問の長さも測定の枠も別々だからだ。同じ著者の姉妹リポジトリ同士でも0.45ミリ秒ずれるという事実は、他人同士の数字を引き算する危うさをよく示している。
各プロジェクトが自分で注意書きを置いている点も見ておきたい。Laya-MLXは「長さ・質問数・実行条件が変われば遅延も変わる」と書き、Snakeデモの毎秒あたりの手数は1問APIベンチマークとは別物だと明記する。Core ML版は「速度比×平均電力比=エネルギー比であり、エネルギーに再度時間を掛けると二重計上になる」とまで書いている。数字を作った側が誤用の仕方を先に塞いでいるので、読む側はその線を越えないほうがいい。
自分で検証できる範囲が違う
選定で効くのは、公称値そのものより「自分で確かめられるか」だ。ここが2系統でいちばんはっきり分かれる。
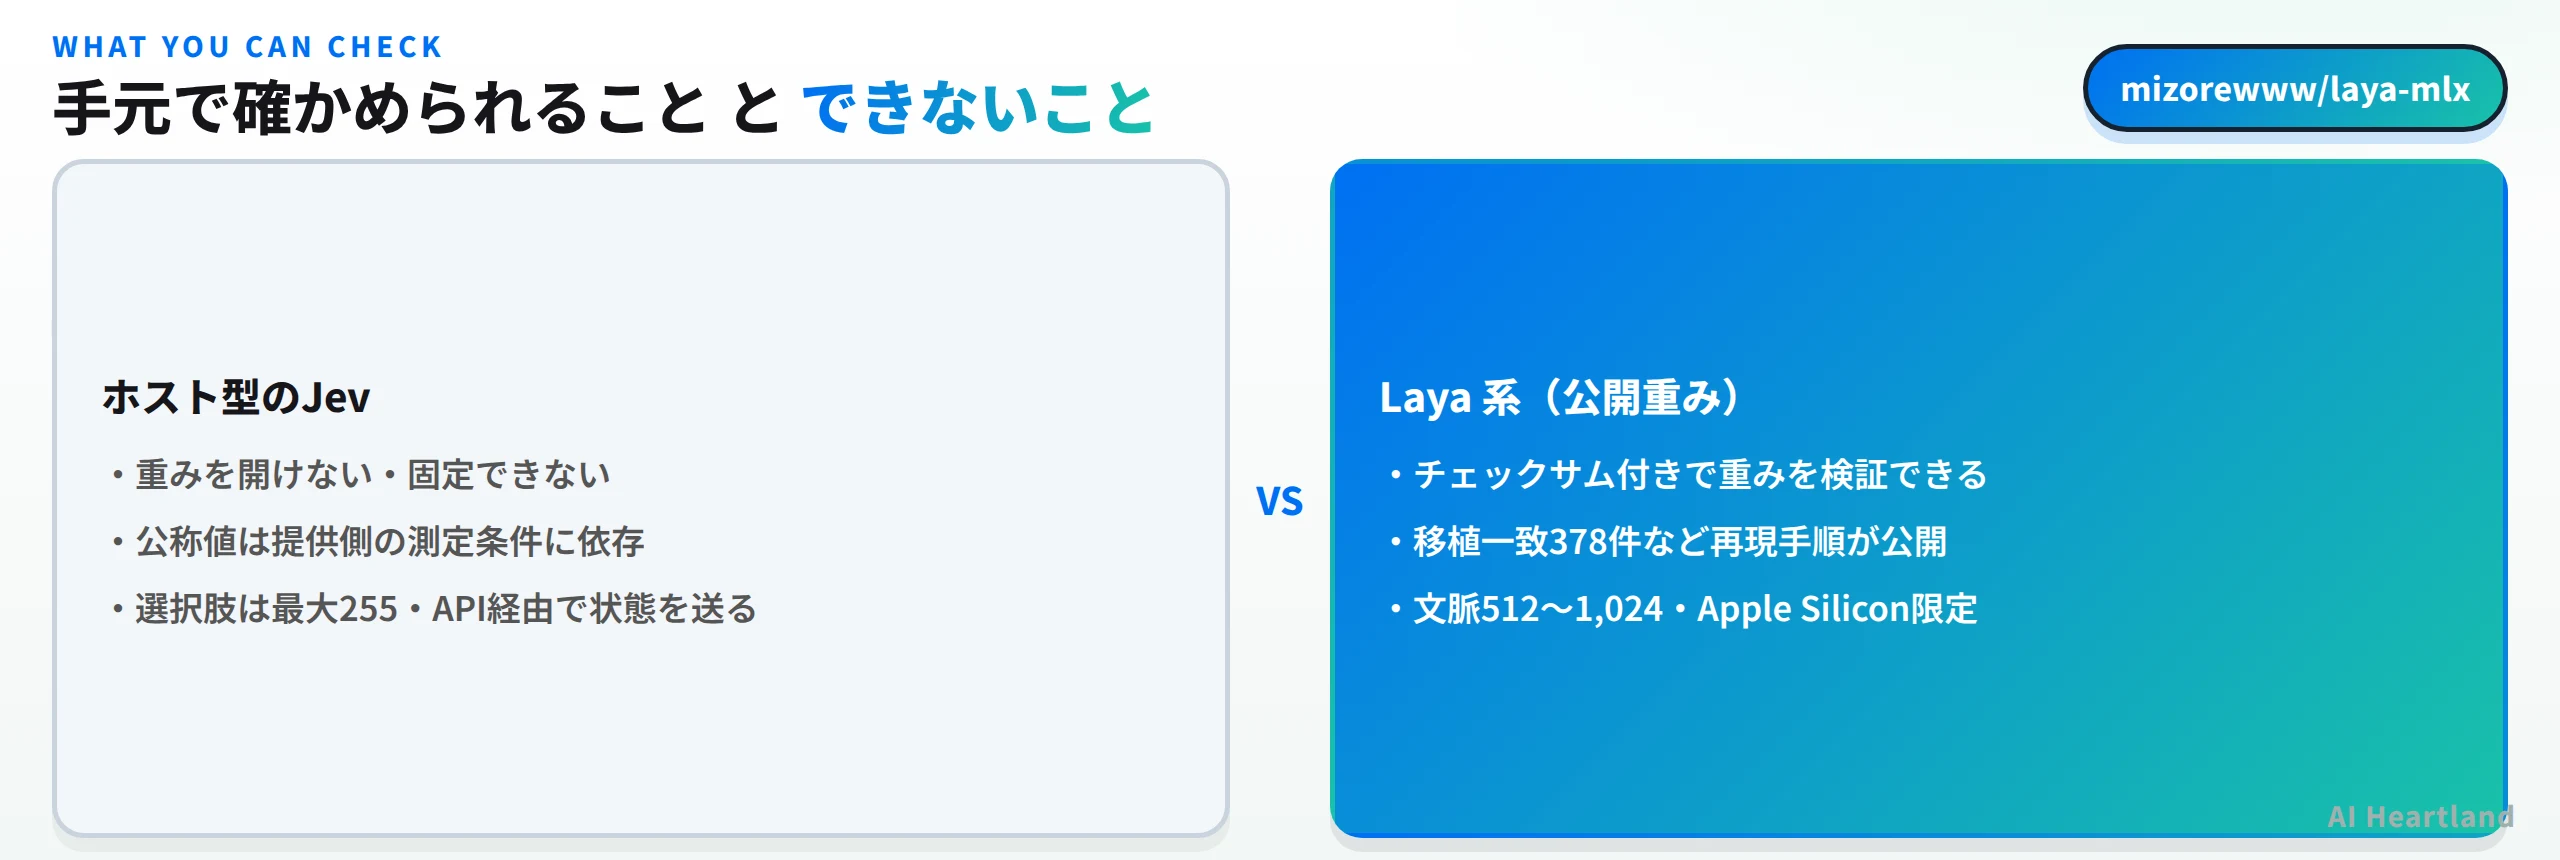
Laya側は検証の材料を揃えている。MLX版は3つのチェックポイントすべてがFP32とFP16の両方で上流の答えと63問中63問一致し、合計378件の比較として公開している。公開した36ファイルは厳密なリモートチェックサム検証に通り、固定したリビジョンと重みのハッシュがリポジトリ内のJSONに記録されている。Core ML版は移植の一致に加えて、6ビットと4ビットの実験が合格線を越えなかったため重みとして公開していないことまで書いている。
さらに、実行環境を持たない読者にも一部は届く。当サイトがLinuxで試した範囲では、Core ML版は導入とimportが通り、Core MLを必要としないテスト66件が全て成功した。MLX版は mlx が条件つき依存のため import すら通らず、テストも収集できなかった。同じ作者の姉妹実装でも、Apple機なしで確かめられる範囲は依存の宣言ひとつで変わる。
この「確かめられる範囲」には段階がある。重みのハッシュが公開されていれば配布物の同一性を確認でき、変換スクリプトが公開されていれば元の重みとの対応を自分で取り直せ、テストが手元で走れば挙動の回帰を見られる。Laya側はこの3段階をすべて用意しており、公開準備のスクリプトが書き出した全テンソルを元のFP16と突き合わせるところまで含まれる。加えてCore ML版は、公開しているSnakeの記録を読み込んで盤面と行動が1手ずつ再現できるかを確かめるテストを持つ。デモの映像そのものが機械検証の対象になっている形で、見せ方と検証が分離していない。
一方でCI の範囲は限定されていることも書かれている。MLX版のGitHub Actionsで走るのはmacOS arm64ランナー上の小モデルCPUテストだけで、実チェックポイントのGPUベンチマークはローカル測定でありホスト型CIには含まれない。つまり公開されている速度の数字は、第三者が押すボタンで再生産されるものではない。再現手順は揃っているが、再現は読者の手元で行う前提だ。
ホスト型のJevでできるのは、返ってきた答えの妥当性を自分のタスクで評価することまでだ。重みを開くことも、版を固定して同じ答えを再現し続けることも、測定条件を変えて測り直すこともできない。これは欠点というより性質で、提供側がモデルを差し替えても呼び出し側は変えなくてよいという利点と表裏になっている。
OpenJevは中間にいる。wire APIはJevに合わせつつ、載せているモデルはApache-2.0の公開重みなので、版を固定して手元で動かせる。ただし互換には差分があり、READMEは選択肢の上限が128であること(Jevは255)、固定版のモデル名を指定すると400が返ること、選択肢1個の質問はトークンを消費せず即答すること(Jevは同じ値を返すが課金する)などを列挙している。詳細はOpenJevとは|Jev互換のSystem One決定サーバを自前GPUで動かすOSSをソースで実測にまとめた。
同じ型でも中身が違う——確信度の定義と費用の形
確信度は3者で別々に定義されている
型が3つとも同じなので、返り値も同じ意味だと思いがちだが、確からしさの表し方は実装ごとに別の定義を持つ。判定を自動処理に流すなら、ここを取り違えると設計が狂う。
この記事のポイント
・比べるべきは公称レイテンシではなく、重みの入手性・実行場所・検証可能性・上限の4点
・各プロジェクトの数字は測定機もハーネスも質問数も違うので、横に並べても選定の根拠にならない
・確信度の定義と較正の扱いが実装ごとに違うため、しきい値は自分のタスクで決め直す必要がある
OpenJevはREADMEに式を書いている。confidence は 1 − H(p)/ln K、つまり分布のエントロピーを選択肢数で正規化した値で、モデルが確信しているとき1、分布が一様のとき0になる。モデルが自分の自信について申告した数字ではなく、分布から計算した値だという点が明示されている。
Laya側は較正温度という別の仕組みを持つ。学習時に当てはめた温度をロジットに適用してから確率にするのだが、上流のv0.3.5に合わせてその温度が0.5から5.0の範囲に制限された。理由も具体的で、出荷されている choice:11+ バケットの値は0.1006、そのまま使うとロジットを約10倍鋭くしてしまい、五分五分の判断をほぼ確実だと報告してしまう。MLX版とCore ML版の両方に同じ変更が入っており、読み込み時に制限のかかったバケットが警告で名指しされ、生の値は temperature_raw から読める。
ホスト型のJev側については、当サイトが以前に確認した範囲で、選択されたカテゴリの確率と提供側のconfidenceが別の値であり、どちらも較正済みだとは主張されていないという断りが周辺のドキュメントに置かれていた。つまり3者とも「確率が返る」ことは同じでも、その目盛りの作られ方はそれぞれ違う。
実務上の帰結は単純だ。あるモデルで決めたしきい値を、別のモデルにそのまま持ち込めない。0.8で自動化して0.8未満を人に回す、といった運用は、モデルを替えたら必ず引き直す必要がある。移行の検討では、速度より先にこの作業の手間を見積もったほうがいい。
運用コストの形も違う
費用の出方も対照的だ。ホスト型は判定1件ごとに課金が積み上がり、手元で動かす場合は初期の準備と電力に寄る。単価の比較表を作りたくなるところだが、公開情報の粒度が揃っていないので、ここでは「何が費用になるか」の形だけを押さえる。
・ホスト型:呼び出し回数に比例。入力トークン数が課金の基準になる。ハードウェアの準備は不要
・Laya系:重みのダウンロードが一度きり。以後は手元の計算資源のみ。Core ML版は1判定あたりのシステム全体のエネルギーまで測っており、ANE FP16で0.1540J、比較対象のMLX FP16で0.4288Jという値を出している
・OpenJev:GPUの確保が固定費。24GB級のGPUと約18GBの重みダウンロードが前提で、そのうえで並列度を上げるほど1件あたりの負担が下がる
細かいが見落としやすい差もある。OpenJevのREADMEは「選択肢が1個の質問やスコアが1段階の質問は、読み取りをせずに確率1で即答しトークンを消費しない。Jevは同じ値を返すが課金する」と書いている。挙動が同じでも請求が違うという粒度の差分が明文化されているのは、移行を検討する側には親切だ。
電力の数字については、測り方そのものへの注意書きも併記されている。Core ML版はSMCのPSTRセンサーの直接読み出しを使い、生サンプルと明示的な異常値除去を伴うとしたうえで、センサーと背景負荷の不確かさを含む推定だと断っている。手元で回す側の費用は、こうした測定を自分の機械で取り直さない限り確定しない。
どう選ぶか——比べるべきは数字でなく前提
比較表を眺めるより、条件を順に当てるほうが早い。
322M〜421Mを端末内で"] D -->|いいえ| F["OpenJev
24GB級GPUに26Bを載せる"] C --> G["版の固定や再現が要るか"] G -->|要る| B G -->|不要| H["ホスト型のまま運用"]
第一の問い、状態を外部に送れるか。判定に渡す「状態」は顧客の問い合わせ文や社内文書そのものであることが多い。ここが塞がっているなら、選択肢は手元で動かす2つに絞られる。
第二の問い、手元のハードウェアは何か。Apple Siliconが前提ならLaya系が素直だ。Linuxサーバやクラウドの汎用GPUならOpenJevになる。ここは好みではなく、実装の対応範囲で決まる。
なお第二の問いには、当サイトがLinuxで実際に確かめた落とし穴がある。Laya系のうちMLX版は mlx を「darwinかつarm64のとき」という条件つき依存として宣言しているため、Linuxでは pip install が成功したうえで import が失敗する。導入できたことと動くことが一致しない。Core ML版のほうは coremltools が無条件の依存なので import までは通り、Core MLを使わないテストは動く。同じ作者の姉妹実装でも、Apple機を用意する前に確かめられる範囲が違うので、評価の段取りを組むときはここを先に見ておきたい。
第三の問い、版を固定して再現したいか。監査や回帰テストの対象になる判定なら、重みとリビジョンを固定できることの価値は大きい。逆に、提供側の改善を自動的に受け取りたい用途ならホスト型のほうが向く。
移行の手間も、選ぶ道によって桁が違う。OpenJevは受け付けるモデル名の集合に jev-latest と jev-preview を明示的に含んでおり、ソースのコメントにも「TypeSafeのSDKが変更なしで動くように受け付ける」と書かれている。つまりホスト型からの移行は、接続先のURLとキーを差し替えるだけで済む可能性が高い。呼び出し側のコードを触らずにモデルの置き場所だけを変えられるというのは、検証の負担を大きく下げる。
対してLaya系への移行は、APIの形そのものが変わる。Pythonから laya.load() でエージェントを作り、predict() に状態と質問の辞書を渡す設計で、HTTPのエンドポイントを叩く構造ではない。質問の型は同じでも、呼び出しの入口は書き直しになる。加えて、選択肢が多い質問ではトークン予算の共有という制約があり、必要なら絞り込みを自分で挟む。同じ判定をさせるにも、移行の作業量はOpenJev経由とLaya系で明確に差がある。
判定モデルを呼ぶ側のツールがどの層にどれだけあるかはJev対応OSS 11選|ブラウザ操作・MCP・コードレビュー・Claude Code文脈選別まで実測で見る使いどころに一覧がある。接続先を差し替える設計にしておけば、この3つの問いの答えが変わったときの移行コストは下げられる。
結論
LayaとJevは、同じ「文章を書かない判定」という看板を掲げながら、成り立ちが違う。片方は小さな重みを配って端末に載せる方向、もう片方はモデルを預かってAPIで提供する方向だ。どちらが優れているかではなく、自分の制約に合うのはどちらかという問いになる。
ホスト型のJevが向く:手元にハードウェアを置かない。提供側の改善を自動で受け取りたい。選択肢が多い質問を扱う(上限255)
OpenJevが向く:SDKを変えずに自前運用へ移したい。24GB級のGPUがある。公開重みで版を固定したい
もうひとつ、どちらを選んでも変わらない作業がある。判定の確率をどこで切るかは、モデルではなく自分のタスクが決める。較正の扱いが実装ごとに違う以上、しきい値は移行のたびに引き直すことになる。逆に言えば、しきい値を決めるためのデータセットを先に作っておけば、モデルの乗り換えは評価をやり直すだけの作業に落ちる。乗り換えのコストを下げる投資は、モデル選びではなく評価セット作りのほうにある。
本記事で挙げた数値は、すべて各プロジェクトのREADMEとベンチマーク資料の記載であり、当サイトが同一条件で測り直したものではない。むしろ本記事の主張は「同一条件での比較は公開されていないので、公称値を横に並べても選定の根拠にはならない」という点にある。実際に選ぶときは、自分の質問セットと自分の機械で、同じハーネスに載せて測り直すのが唯一の近道になる。
参照ソース
・mizorewww/laya-mlx — Laya の MLX 移植。チェックポイント表・測定条件・移植一致の検証(2026-09-22時点で確認)
・mizorewww/laya-coreml — Core ML/Neural Engine 版。電力測定と公開しなかった実験の記録
・razorback16/openjev — Jev 互換サーバ。Jevとの既知の差分一覧とスループット計測